AI-Native Observability | AI Agents වලටත් Debug කරන්න පුළුවන් Software හදමු!
 Tharuka Sarathchandra · Nov 8, 2026 · 3 මිනිත්තු කියවීමක්
AI Coding Agents භාවිතයෙන් අද අපිට ඉතා වේගයෙන් Software Develop කරන්න පුළුවන්.
නමුත් Software එක Production එකට Deploy කළාට පස්සේ, සැබෑ Users ලා භාවිත කරනකොට ඇතිවන Issues හඳුනාගෙන විසඳන්නේ කොහොමද?
විශේෂයෙන්ම දිගු කාලයක් Maintain කරන්න අවශ්ය Durable Software නිර්මාණය කරනකොට මේක ඉතා වැදගත්.
මෙතැනදී තමයි Observability කියන සංකල්පය වැදගත් වෙන්නේ.
Observability කියන්නේ මොකක්ද?
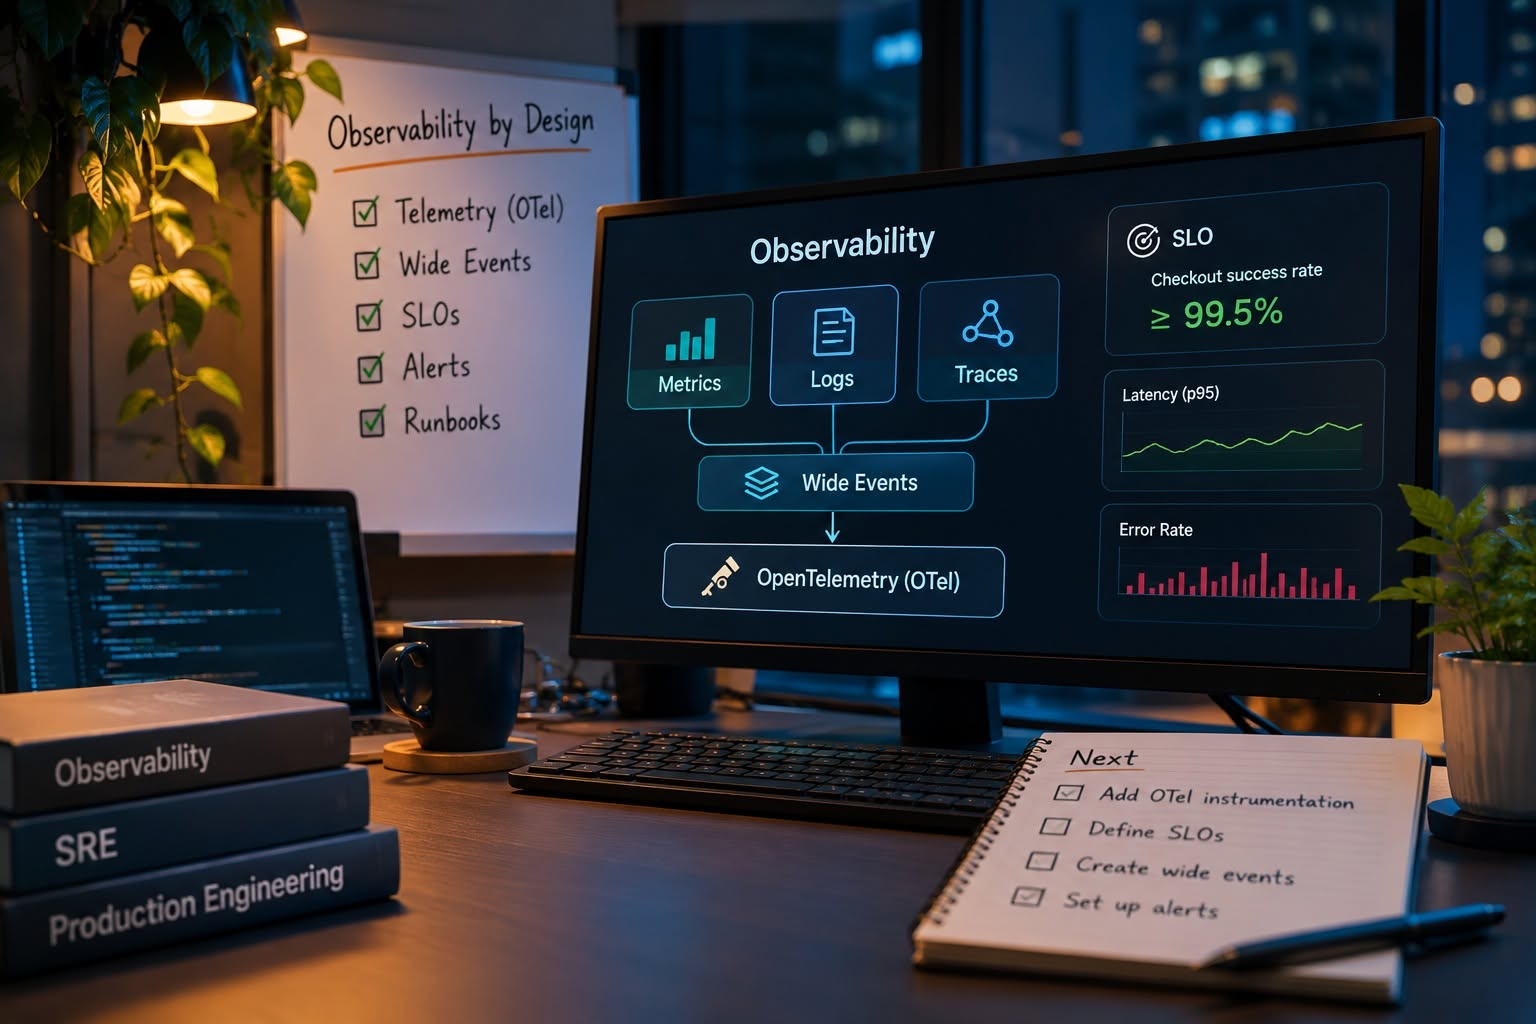
සරලව කිව්වොත්, Production System එකක් ඇතුළේ මොකක්ද සිදුවෙන්නේ, ඇයි එහෙම වෙන්නේ කියලා System එකෙන් ලැබෙන Data භාවිතයෙන් තේරුම් ගැනීමේ හැකියාවයි.
මෙහි ප්රධාන Three Pillars තුනක් තියෙනවා.
- Metrics: Error Rates, Latency සහ System Performance වගේ දේවල් මැනීම.
- Logs: System එක තුළ සිදුවූ Events සහ Errors පිළිබඳ විස්තර ලබාගැනීම.
- Traces: Request එකක් Services කිහිපයක් හරහා ගමන් කරන ආකාරය හඳුනාගැනීම.
නමුත් මේ Data වෙන වෙනම එකතු කිරීම පමණක් ප්රමාණවත් නැහැ.
මෙතැනදී Wide Events කියන සංකල්පය වැදගත් වෙනවා. ඒ කියන්නේ Request එකකට අදාළ Service, Trace ID, Duration, Error, Deployment Version සහ Business Context වගේ විස්තර රාශියක් එකම Structured Event එකක සටහන් කිරීමයි.
මේ විස්තර එකිනෙකට සම්බන්ධ කරලා පරීක්ෂා කිරීමෙන් ගැටලුව ඇතිවුණේ කොතැනද කියලා හඳුනාගැනීම පහසු වෙනවා.
SLO (Service Level Objective) කියන්නේ මොකක්ද?
System එකේ Health එක CPU හෝ Memory Usage වලින් විතරක් මනින්න බැහැ. Users ලාට ලැබෙන Service එක කොතරම් විශ්වාසදායකද කියන එකත් වැදගත්.
උදාහරණයක් විදිහට, මාසයක් තුළ Checkout Requests වලින් 99.5%ක් තත්පරයක් ඇතුළත සාර්ථකව අවසන් විය යුතුයි කියලා Target එකක් නිර්වචනය කරන්න පුළුවන්.
ඒක SLO එකක්. මෙවැනි Targets භාවිතයෙන් සැබෑ User Experience එකට බලපාන Issues හඳුනාගෙන Alerts Prioritize කරන්න පුළුවන්.
AI Agents මෙතැනට සම්බන්ධ වෙන්නේ කොහොමද?
හිතන්න රාත්රී 2ට සාමාන්ය Production Application එකක Issue එකක් ඇතිවෙනවා කියලා.
Observability Data, Code Repository සහ Deployment History වලට ප්රවේශය තියෙන AI Agent එකකට:
- Alert එක හඳුනාගෙන Logs, Metrics සහ Traces විශ්ලේෂණය කරන්න.
- Code Changes සහ Dependencies පරීක්ෂා කරලා Root Cause එක හඳුනාගන්න උත්සාහ කරන්න.
- Fix එකක් යෝජනා කරලා Tests සහ Validation සිදු කරන්න.
මෙහිදී කලින් Post එකක කතා කළ One-Way / Two-Way Door සහ Blast Radius සංකල්ප වැදගත් වෙනවා.
Low-Risk + Easily Reversible Changes සඳහා කලින් නිර්වචනය කළ ආරක්ෂක සීමාවන්, Automated Validation සහ Rollback Mechanisms යටතේ Agent එකට Fix එකක් Deploy කරලා Engineer ට Notify කරන්න ඉඩ දෙන්න පුළුවන්.
නමුත් High-Risk Changes සඳහා Root Cause Analysis, Evidence සහ Proposed Fix එක සූදානම් කරලා Human Approval ඉල්ලන්න පුළුවන්.
එතකොට Engineer කෙනෙක්ට මුල ඉඳන් Debug කරනවා වෙනුවට අවශ්ය Context එකත් එක්ක තීරණයක් ගන්න පුළුවන්. Critical Incidents සඳහා Human Escalation තවමත් අවශ්යයි.
Software Engineers විදිහට අපි අවධානය දෙන්න ඕන මොකක්ද?
Observability කියන්නේ Production Issue එකක් ආවට පස්සේ එකතු කරන දෙයක් නෙවෙයි.
Software Design කරන මුල් අවස්ථාවේ ඉඳන්ම Observability-Driven Development ගැන හිතන්න ඕන. ඒ සඳහා Structured Telemetry, Correlation IDs, Meaningful Alerts, SLOs සහ අවශ්ය Business Context කලින්ම සැලසුම් කිරීම වැදගත්.
AI-Native Software Engineering කියන්නේ AI භාවිතයෙන් Code Generate කිරීම විතරක් නෙවෙයි.
AI සහ Humans දෙපාර්ශ්වයටම Production System එක තේරුම් ගන්න, Issues හඳුනාගන්න සහ ආරක්ෂිතව විසඳන්න පුළුවන් විදිහට Software එක Design කිරීමත් එහි කොටසක්.
මෙහිදී අපි කතා කළේ සාමාන්ය Deterministic Software වල Production Observability සහ ඒවායේ Issues විසඳීමට AI Agents භාවිත කිරීම ගැනයි. Non-Deterministic AI Agents වල Behavior, Decisions සහ Tool Calls නිරීක්ෂණය කරන Agentic AI Observability ගැන ඉදිරි Post එකකින් කතා කරමු.